การทำนายการกระทำของมนุษย์
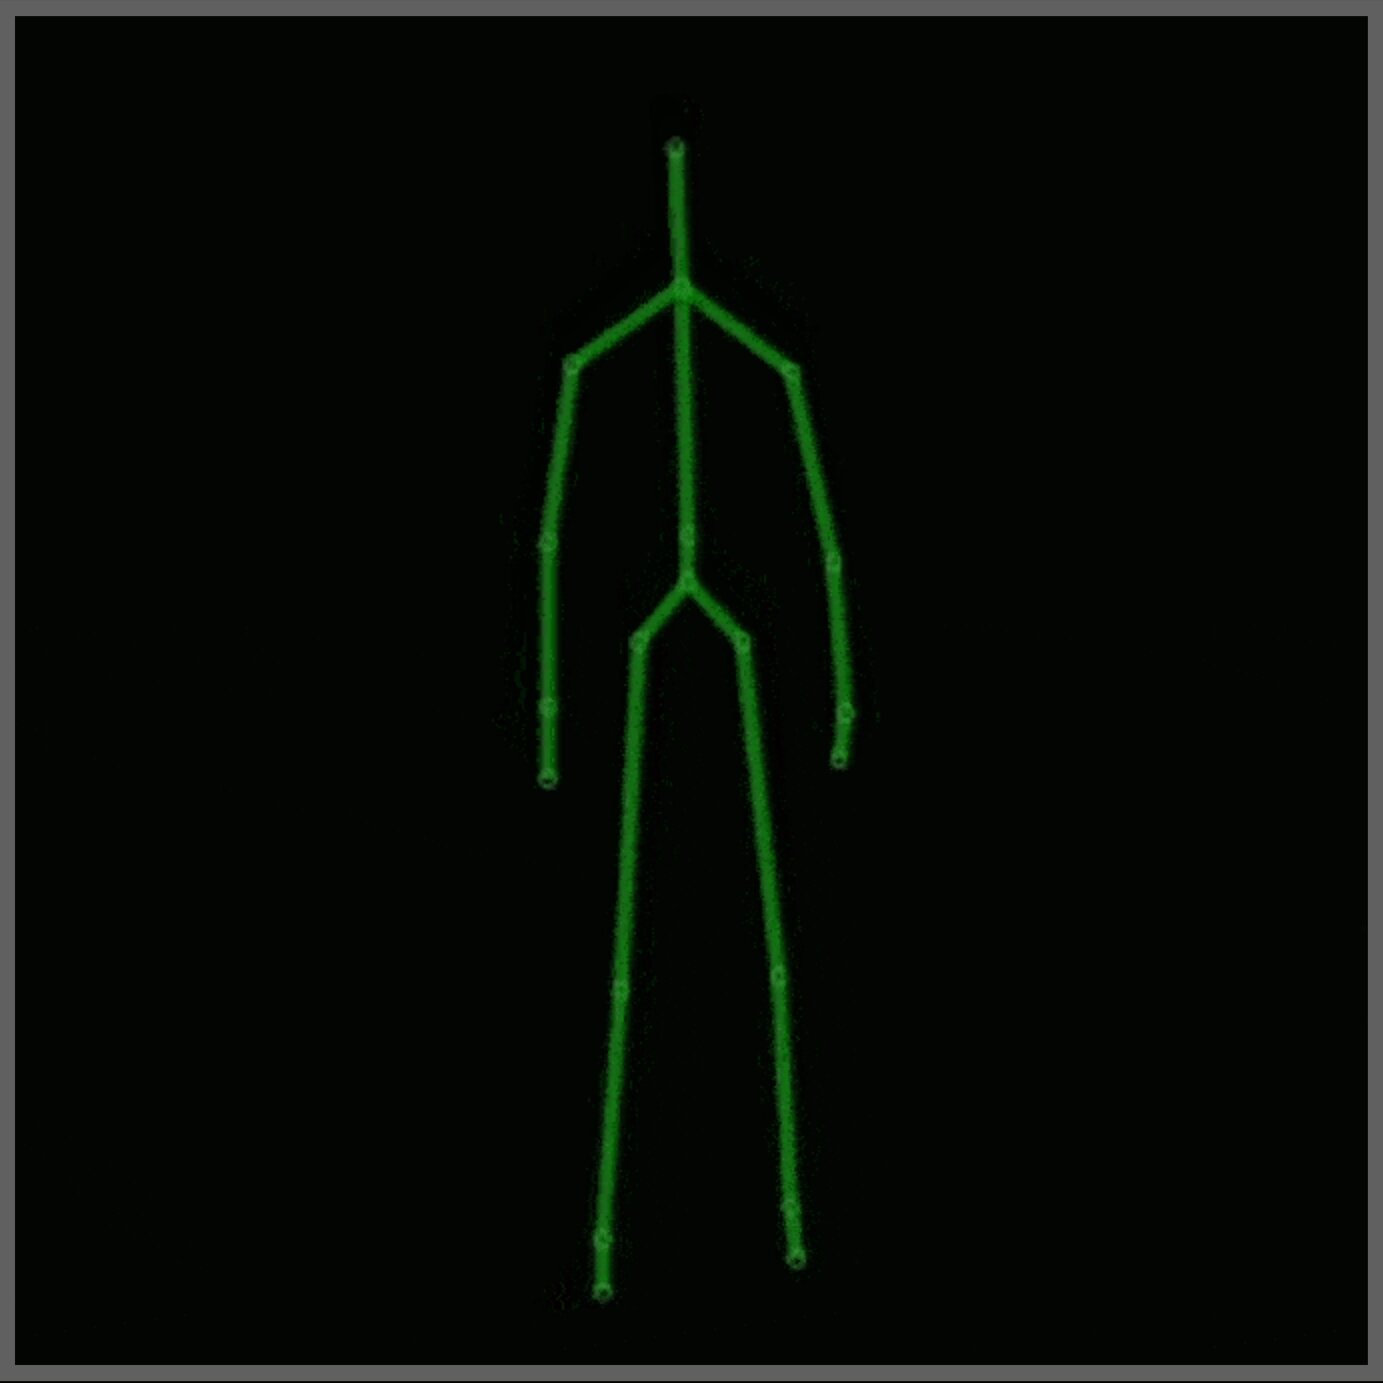
รายละเอียด
โครงการนี้เป็นโครงการที่ 3 สำหรับชั้นเรียน Human Centered Robotics (CSCI473) ของ Dr. Zhang ที่ Colorado School of Mines ในภาคการศึกษาฤดูใบไม้ผลิปี 2020 โครงการนี้ได้รับการออกแบบมาเพื่อแนะนำการเรียนรู้ของเครื่องในวิทยาการหุ่นยนต์ผ่านการใช้ Support Vector Machines (SVM) สามารถดูสิ่งที่ต้องส่ง/คำอธิบายโครงการฉบับต้นฉบับได้ ที่นี่
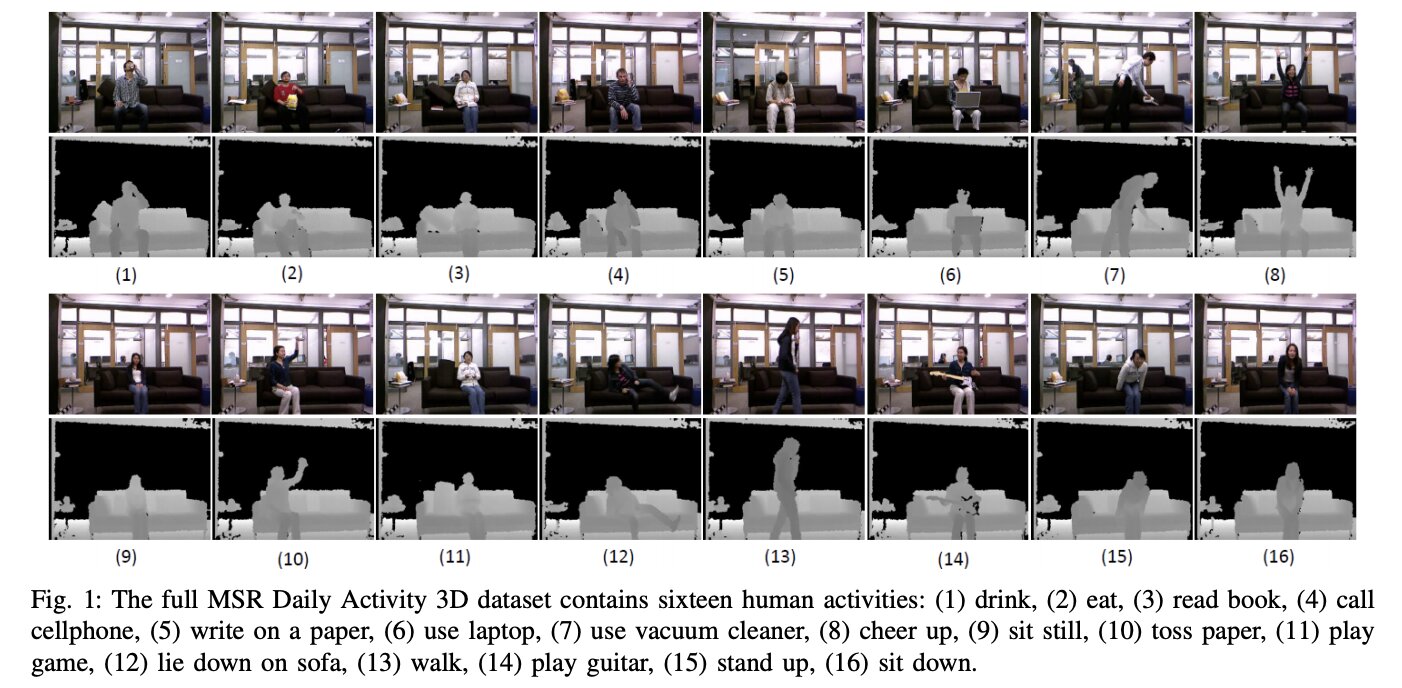
สำหรับโครงการนี้ ได้ใช้ ชุดข้อมูล MSR Daily Activity 3D (รูปที่ 2) โดยมีการปรับเปลี่ยนบางส่วน ชุดข้อมูลนี้ประกอบด้วยกิจกรรมของมนุษย์ 16 กิจกรรม ซึ่งรวบรวมจากเซนเซอร์ Xbox Kinetic และจัดเก็บในรูปแบบโครงกระดูก โครงกระดูกคืออาร์เรย์ของพิกัด (x, y, z) ในโลกจริงของข้อต่อ 20 จุดของมนุษย์ที่บันทึกไว้ในหนึ่งเฟรม นี่คือภาพที่แสดงว่าโครงกระดูกคืออะไร:
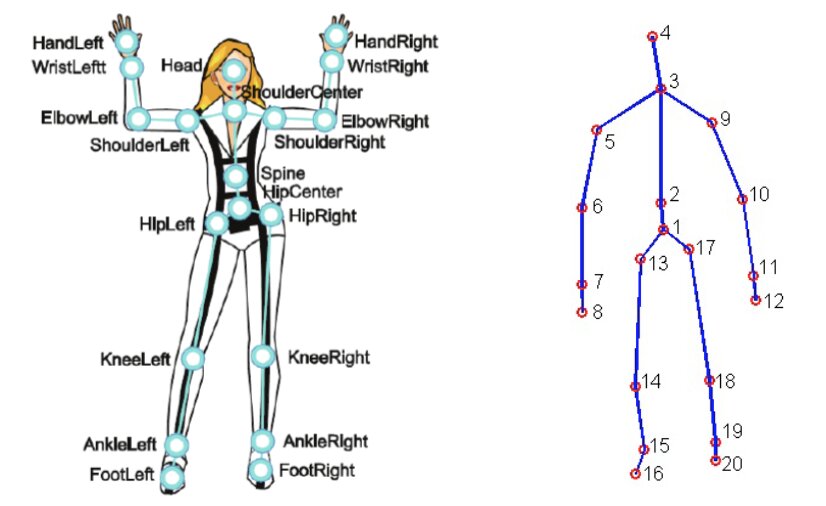
เพื่อให้บรรลุการทำนายการกระทำของมนุษย์ ข้อมูลดิบจะต้องถูกแทนให้อยู่ในรูปแบบที่สามารถประมวลผลโดย SVM ได้ สำหรับโครงการนี้ ใช้รูปแบบการแทนข้อมูลดังต่อไปนี้:
- รูปแบบการแทนมุมและระยะทางสัมพัทธ์ (RAD)
- รูปแบบการแทนฮิสโตแกรมของความแตกต่างของตำแหน่งข้อต่อ (HJPD)
สำหรับการจำแนกประเภท รูปแบบการแทนข้อมูลจะถูกส่งเข้าไปยัง SVM ซึ่งขับเคลื่อนโดย LIBSVM เพื่อสร้างโมเดลที่สามารถทำนายการกระทำของมนุษย์ได้ โดยจะสร้างโมเดลสองโมเดล โมเดลหนึ่งใช้ RAD และอีกโมเดลหนึ่งใช้ HJPD เป้าหมายคือทำให้โมเดลเหล่านี้มีความแม่นยำมากที่สุดเท่าที่จะเป็นไปได้ และดูว่ารูปแบบการแทนข้อมูลใดทำงานได้ดีที่สุด
เมื่อทราบดังนี้แล้ว นี่คือภาพรวมของสิ่งที่โค้ดทำ:
- โหลดข้อมูลดิบจากชุดข้อมูลที่ปรับเปลี่ยนแล้ว
- ลบข้อมูลที่เป็นค่าผิดปกติและ/หรือข้อมูลข้อผิดพลาดออกจากชุดข้อมูลที่โหลดมา
- แปลงข้อมูลดิบขั้นสุดท้ายให้เป็นรูปแบบการแทน RAD และ HJPD
- ส่งรูปแบบการแทนข้อมูลเข้าไปยัง SVM ที่ได้รับการปรับแต่งแล้ว เพื่อสร้างโมเดลสองโมเดล
- จากนั้นป้อนข้อมูลดิบสำหรับการทดสอบเข้าไปในโมเดลทั้งสอง และสร้างเมทริกซ์ความสับสนเพื่อวัดว่าโมเดลทำงานได้ดีเพียงใด
ผลลัพธ์
หลังจากเรียกใช้โค้ดและปรับแต่งโมเดลอย่างดีที่สุดเท่าที่ทำได้ นี่คือเมทริกซ์ความสับสนขั้นสุดท้ายสำหรับโมเดล RAD และ HJPD:
Representation: RAD
Accuracy: 62.5%
LIBSVM Classification   8.0   10.0  12.0  13.0  15.0  16.0
Actual Activity Number
8.0                        8     0     0     0     0     0
10.0                       1     5     0     0     1     1
12.0                       0     1     1     0     3     3
13.0                       0     0     0     6     1     1
15.0                       0     0     0     1     5     2
16.0                       0     0     0     0     3     5
Representation: HJPD
Accuracy: 70.83%
LIBSVM Classification   8.0   10.0  12.0  13.0  15.0  16.0
Actual Activity Number
8.0                        7     1     0     0     0     0
10.0                       1     5     0     0     0     2
12.0                       0     0     7     0     1     0
13.0                       2     0     1     5     0     0
15.0                       0     0     0     0     7     1
16.0                       0     2     0     0     3     3
บทสรุป
เนื่องจากความแม่นยำทั้งสองค่ามากกว่า 50% โครงการนี้จึงประสบความสำเร็จ นอกจากนี้ รูปแบบการแทน HJPD ดูเหมือนจะเป็นรูปแบบการแทนข้อมูลที่มีความแม่นยำมากกว่าในการใช้สำหรับการจำแนกประเภทนี้ ด้วยเหตุนี้ จึงมีโมเดลที่สามารถทำนายการกระทำของมนุษย์โดยใช้ข้อมูลโครงกระดูก โมเดลในที่นี้ยังห่างไกลจากความสมบูรณ์แบบ แต่ก็ดีกว่าการสุ่ม โครงการนี้เป็นจุดกำเนิดของโครงการ Moving Pose ในเวลาต่อมา
หมายเหตุเพิ่มเติม:
- โครงการนี้ได้รับการทดสอบบน Python เวอร์ชัน 3.8.13
- สำหรับโครงการนี้ ใช้ชุดข้อมูล MDA3 ฉบับสมบูรณ์และชุดข้อมูล MDA3 ที่ปรับเปลี่ยนแล้ว โดย MDA3 ฉบับปรับเปลี่ยนมีเฉพาะกิจกรรม 8, 10, 12, 13, 15 และ 16 นอกจากนี้ เวอร์ชันที่ปรับเปลี่ยนยังมีจุดข้อมูลที่ “เสียหาย” บางจุดอยู่ด้วย ในขณะที่ชุดข้อมูลฉบับสมบูรณ์ไม่มี
- การแทนผู้คนด้วยข้อมูลโครงกระดูก 3 มิติตามกาล-อวกาศ: บททบทวน
- YouTube: เซนเซอร์วัดความลึก Kinect ทำงานอย่างไรใน 2 นาที
- Medium: ทำความเข้าใจข้อต่อ Kinect V2 และระบบพิกัด
- หน้า Wikipedia ของ Kinect
- Jameco Xbox Kinect
- ข้อมูลเกี่ยวกับ SVM และ LibSVM: cjlin libsvm, หน้า libsvm บน pypi และ libsvm บน github
- ตรรกะและเอกสารประกอบ SVM และ LIBSVM: เอกสารคู่มือของ cjlin และ ชุดข้อมูล libsvmtools ของ cjlin
- ข้อมูลเกี่ยวกับชุดข้อมูลที่ใช้/ปรับเปลี่ยน