InsightRed सह ABM विपणन
परिचय
InsightRed हे LLM-सक्षम खाते-आधारित विपणन (ABM) साधन आहे, जे Subreddits मधून “Hot” नुसार क्रमवारी लावलेल्या नवीनतम Reddit टिप्पण्या काढते आणि तुमच्या प्रकल्पात किंवा उत्पादनात संभाव्य स्वारस्य दर्शविणाऱ्या वापरकर्त्यांना ओळखते. Reddit वर उच्च-मूल्य असलेले वापरकर्ते ओळखून त्यांना लक्ष्य करण्यास, तसेच तुमच्या उत्पादन/प्रकल्पासाठी सुरुवातीचे वापरकर्ते मिळविण्यास हे तुम्हाला मदत करते. हा प्रकल्प ANARCHY ऑक्टोबर 2023 हॅकाथॉनसाठी तयार करण्यात आला होता.
घोषणा
19 ऑक्टोबर, 2023
या प्रकल्पाच्या पुढील टप्प्याच्या रूपात, Anarchy च्या ऑक्टोबर 2023 हॅकाथॉनमध्ये आम्ही प्रथम क्रमांक पटकावला असल्याची घोषणा करताना मला अत्यंत आनंद होत आहे!
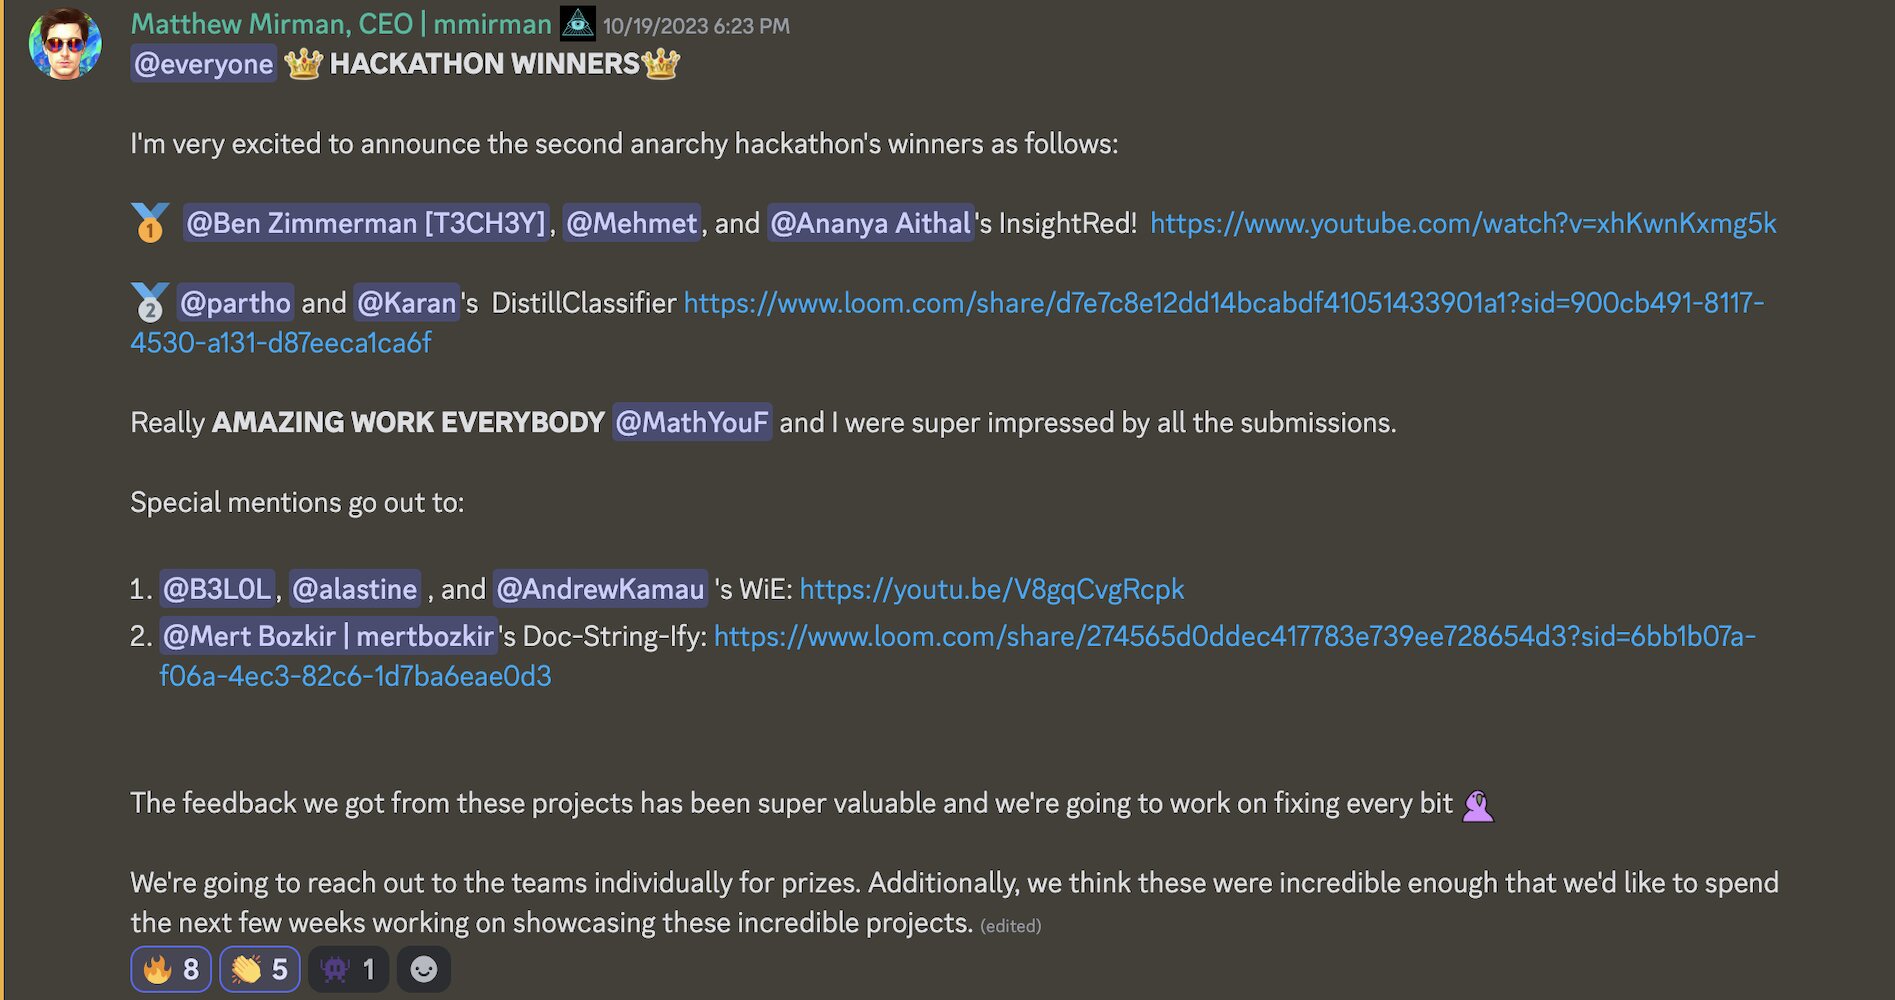
TEXT मोडमध्ये संदेश पाहण्यासाठी येथे क्लिक करा (Discord च्या स्वरूपनामुळे बदललेले)
@everyone **👑 HACKATHON 👑**

I'm very excited to announce the second anarchy hackathon's winners as follows:

🥇 "@Ben Zimmerman [T3CH3Y]", @Mehmet, and "@Ananya Aithal"'s InsightRed! https://www.youtube.com/watch?v=xhKwnKxmg5k

🥈 @partho and @Karan's  DistillClassifier https://www.loom.com/share/d7e7c8e12dd14bcabdf41051433901a1?sid=900cb491-8117-4530-a131-d87eeca1ca6f

Really **AMAZING WORK EVERYBODY** @MathYouF and I were super impressed by all the submissions.

Special mentions go out to:

1. @B3LOL, @alastine , and @AndrewKamau 's WiE: https://youtu.be/V8gqCvgRcpk
2. "@Mert Bozkir | mertbozkir"'s Doc-String-Ify: https://www.loom.com/share/274565d0ddec417783e739ee728654d3?sid=6bb1b07a-f06a-4ec3-82c6-1d7ba6eae0d3

The feedback we got from these projects has been super valuable and we're going to work on fixing every bit 🦜

We're going to reach out to the teams individually for prizes. Additionally, we think these were incredible enough that we'd like to spend the next few weeks working on showcasing these incredible projects.
प्रात्यक्षिक
InsightRed चे घटक
🧩 संकलक
संकलक Reddit च्या API चा वापर करून, दिलेल्या Subreddits साठी नवीनतम Reddit पोस्ट आणि त्या पोस्टवरील टिप्पण्या संकलित करतो. संकलन केल्यानंतर, संकलक संकलित केलेला डेटा स्थानिक SQLite डेटाबेसमध्ये जतन करतो. Reddit API वापरण्यास मदत करण्यासाठी praw हे python पॅकेज आणि स्थानिक SQLite डेटाबेसमध्ये CRUD ऑपरेशन्स करण्यासाठी SQLAlchemy वापरल्यामुळे हे काम सुलभ होते.
🧩 वेक्टरायझर
वेक्टरायझर स्थानिक SQLite डेटाबेस तपासून कोणत्या टिप्पण्या वेक्टर डेटाबेसमध्ये जतन केलेल्या नाहीत हे पाहतो. टिप्पण्यांची यादी मिळाल्यानंतर, तो OpenAI च्या “text-embedding-ada-002” मॉडेलचा वापर करून पोस्ट+टिप्पणीचे embedding तयार करतो. हे embedding वेक्टर डेटाबेसमध्ये Index म्हणून वापरले जाते आणि JSON च्या स्वरूपात काही metadata देखील तयार केला जातो. त्यानंतर Index आणि metadata वेक्टर डेटाबेसवर अपलोड केले जातात; या प्रकरणात तो Pinecone (cloud-based) आहे. अपलोड केल्यानंतर, तोच डेटा Pinecone वर पुन्हा अपलोड होऊ नये म्हणून स्थानिक SQLite डेटाबेस अद्ययावत केला जातो. वेक्टर डेटाबेसवर CRUD पर्याय करण्यासाठी Pinecone च्या python client (pinecone-client) आणि embedding प्रक्रिया हाताळण्यासाठी LangChain वापरून हे सर्व केले जाते.
🧩 इंटरफेस
साधनाशी वापरकर्ता संवाद साधण्यासाठी इंटरफेसचा वापर केला जातो. या प्रकरणात, इंटरफेस हा CLI आहे. इंटरफेसमध्ये Retrieval-Augmented-Generation (RAG) ची अंमलबजावणी आहे. यामध्ये वापरकर्ता आपल्या उत्पादनाचे वर्णन, तपासायच्या Subreddits ची यादी तसेच काही फिल्टर्स देतो. हा संदर्भ दिल्यावर, प्रथम संकलकाला आणि त्यानंतर वेक्टरायझरला बोलावले जाते. या दोन सेवांची प्रक्रिया पूर्ण झाल्यानंतर, प्रविष्ट केलेल्या उत्पादनाच्या वर्णनाचा वापर वेक्टर डेटाबेसमध्ये त्यासारखा शोध घेण्यासाठी केला जातो. त्यानंतर शीर्ष परिणाम आणि उत्पादनाचे वर्णन एका prompt template मध्ये दिले जातात, ज्यातून अंतिम prompt तयार होतो. अंतिम prompt नंतर OpenAI च्या GPT-4 मॉडेलकडे पाठवला जातो आणि अंतिम परिणाम वापरकर्त्याला सादर केले जातात. हे परिणाम अशा सर्व Reddit टिप्पण्यांची यादी असतील ज्या, दिलेल्या उत्पादनाच्या वर्णनावर आधारित, Reddit वापरकर्त्याला किंवा वापरकर्त्यांना त्या उत्पादनात स्वारस्य असेल असे ठामपणे सूचित करतात. हा घटक संकलक आणि वेक्टरायझरच्या टिप्पण्यांचा वापर करून, तसेच OpenAI च्या GPT-4 मॉडेलसाठी query हाताळण्यासाठी Anarchy च्या LLM-VM चा वापर करून कार्य करतो.
टीम सदस्य
उल्लेखनीय बाह्य श्रेय
casta (Hacker News)
त्यांच्या HN पोस्ट द्वारे या प्रकल्पासाठी प्रेरणा दिल्याबद्दल. त्यांचे समाधान open-source नसल्यामुळे, मला open-source आवृत्ती (हा प्रकल्प) तयार करण्याची प्रेरणा मिळाली.
ChatGPT (GPT-4)
विकास प्रक्रियेला खरोखर वेग देऊन त्याने विकासासाठी खूप मदत केली. तसेच OpenAI च्या नवीन DALL-E 3 मॉडेलचा वापर करून त्याने प्रकल्पाचा लोगो आणि YouTube thumbnail तयार केला.
James Briggs (YouTuber)
James च्या व्हिडिओने Reddit च्या API चा वापर कसा करायचा, तसेच Python वापरून मूलभूत RAG pipeline कशी अंमलात आणायची हे खरोखर स्पष्ट केले.
स्रोत
- Show HN: Labor Day Fun Project, Find Reddit Comments to Promote Your Business
- Pinecone Indexing Overview Docs
- YouTube: Chatbots with RAG - LangChain Full Walkthrough
- OpenAI API Page
- Pinecone Quickstart Docs
- Reddit: Updated rate limits going into effect over the coming weeks
- Reddit Apps Page
- YouTube: How-to Use The Reddit API in Python
- Medium: Scraping Reddit data using Reddit API
- GitHub Gist: Reddit API
- GitHub: praw
- ChatGPT - Web App